Skills de Agentes IA: Quando Todo Agente Lê o Mesmo Arquivo, o Moat Migra
Em outubro de 2025 a Anthropic transformou conhecimento em arquivo: uma pasta com SKILL.md, YAML e scripts que qualquer agente lê sob demanda. Nove meses depois, mais de 40 ferramentas (Codex, Gemini CLI, Copilot, Cursor) leem o mesmo formato, e o Agent Plugins 1.0.0 uniu Vercel, AWS, Microsoft, OpenAI e GitHub no mesmo padrão. Quando a capacidade de ensinar procedimentos a agentes vira commodity de ecossistema, a vantagem competitiva migra: sai do formato, vai para o conhecimento de domínio proprietário, o contexto institucional e os dados de uso. Este artigo decompõe a anatomia do padrão que venceu, por que ele venceu, e o playbook para instituições brasileiras transformarem processo em skill versionável, auditável e soberana.
Skills de Agentes IA: Quando Todo Agente Lê o Mesmo Arquivo, o Moat Migra
Em 16 de outubro de 2025, a Anthropic anunciou uma coisa tecnicamente banal: uma pasta com um arquivo Markdown dentro. O arquivo tem um cabeçalho YAML com dois campos, name e description, e um corpo de texto que ensina um procedimento. A pasta pode carregar scripts, referências e templates. O nome é Agent Skills, e a proposta é empacotar a expertise de um time em material que o agente carrega sob demanda, como o onboarding de um novo contratado (Anthropic, 2025).
Nove meses depois, esse arquivo virou o padrão de fato para ensinar agentes de IA a executar procedimentos. O showcase oficial do Agent Skills lista mais de 40 clientes, entre eles o Codex da OpenAI, o Gemini CLI do Google, o GitHub Copilot, o Cursor e o VS Code (agentskills.io, 2026). A Microsoft e a OpenAI implementaram o formato em menos de 48 horas após a abertura do padrão. Em agosto de 2026, Vercel, AWS, Microsoft, OpenAI, GitHub e Anysphere lançaram juntos o Agent Plugins 1.0.0, que empacota skills e servidores MCP num único plugin portável (Hefner, 2026). Simon Willison, referência em engenharia de agentes, resumiu o momento no dia do lançamento: "Claude Skills são ótimas, talvez um negócio maior que o MCP" (Willison, 2025).
Este artigo decompõe o que é uma skill, por que o formato venceu tão rápido e o que isso significa para quem constrói produtos de IA. A tese é direta: quando a capacidade de ensinar procedimentos a agentes vira infraestrutura de ecossistema, o diferencial competitivo deixa de estar no formato e migra para as três coisas que não vêm no pacote: conhecimento de domínio, contexto institucional e dados de uso.
A anatomia de uma skill: onboarding para uma máquina
A definição oficial é enxuta: "pastas organizadas de instruções, scripts e recursos que agentes podem descobrir e carregar dinamicamente para performar melhor em tarefas específicas" (Anthropic, 2025). A engenharia por trás é igualmente enxuta. Uma skill é um diretório com um arquivo obrigatório, o SKILL.md, e subpastas opcionais para o que o procedimento exigir: scripts/ com código executável, references/ com documentação profunda, assets/ com templates. A analogia que os próprios engenheiros da Anthropic usam é a de um manual de onboarding: o sumário sempre visível, o capítulo aberto quando a pergunta cai no território dele, o apêndice consultado só quando um passo exige.
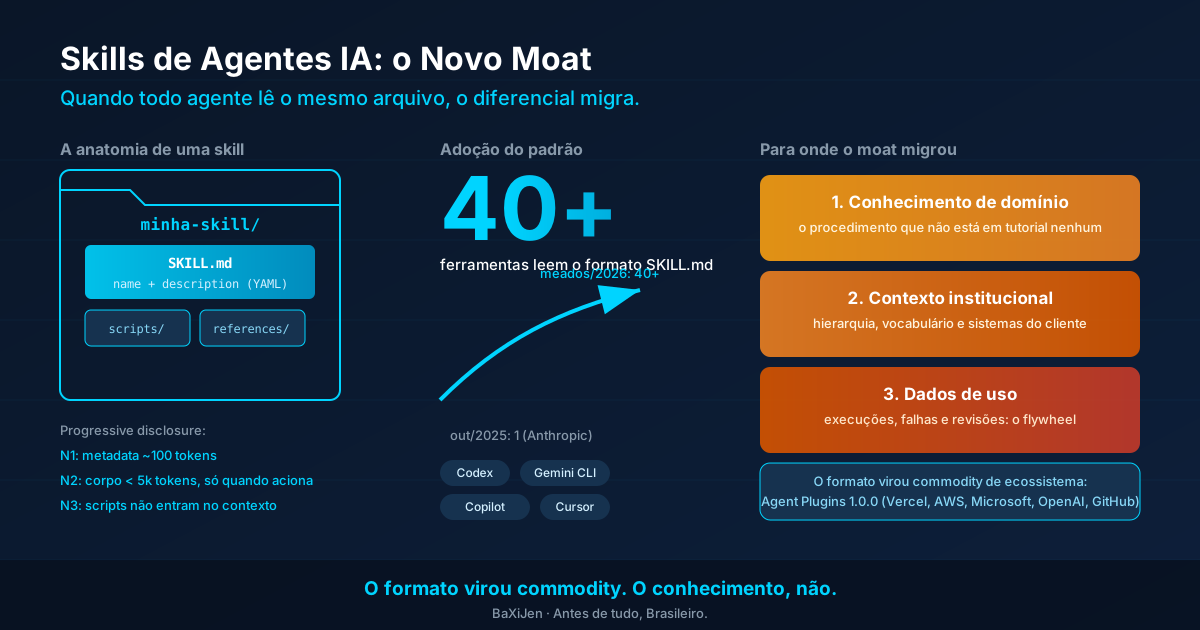
O mecanismo que faz isso escalar chama-se progressive disclosure, e funciona em três níveis (Anthropic, 2025):
| Nível | O que carrega | Quando entra no contexto | Custo aproximado |
|---|---|---|---|
| 1 | name e description de todas as skills instaladas | Sempre, no prompt de sistema | ~100 tokens por skill |
| 2 | Corpo completo do SKILL.md | Quando o agente julga a skill relevante à tarefa | Menos de 5.000 tokens |
| 3 | Arquivos extras, referências, scripts | Quando um passo específico precisa deles | Efetivamente ilimitado até ser lido |
O detalhe que muda o jogo econômico está na terceira linha: um script de 500 linhas que extrai campos de um PDF não entra na janela de contexto. O agente executa o script e consome apenas a saída. O conhecimento fica no disco e paga token só na hora do uso. É por isso que uma biblioteca de dezenas de skills cabe em poucos milhares de tokens de metadata: o custo de manter a especialização disponível é o de um índice, não o de uma biblioteca.
A segunda peça é o campo description. Ele é a única informação que o agente tem quando decide se vai pagar o custo do nível 2, e a documentação oficial é explícita: roteamento é um problema de metadata, e descrição vaga é o bug. Uma skill descrita como "ajuda com documentos" perde para qualquer competidora; uma descrita como "use quando o usuário pedir para preencher formulários PDF e extrair tabelas" dispara corretamente (Anthropic, 2025).
Por que o formato venceu: a commodity certa no momento certo
Padrões ganham quando resolvem um problema real com o menor atrito possível, e a skill venceu em três frentes simultâneas.
Primeira: o custo de criação é quase zero. Escrever uma skill é escrever Markdown. Não exige servidor, SDK, runtime, nem protocolo de transporte. Qualquer time que já documenta seus processos já sabe escrever uma. O GitHub MCP oficial consome dezenas de milhares de tokens ao startup; a skill que descreve o mesmo fluxo como invocação de CLI consome o custo da description até ser acionada (Willison, 2025). A assimetria de custo entre "ensinar por prompt" e "ensinar por skill" desapareceu.
Segunda: o formato é agnóstico a vendor por construção. Uma skill é um arquivo que um modelo consegue ler. Não há runtime proprietário nem símbolo mágico. Willison demonstrou na prática: uma pasta escrita para o Claude funciona apontada para o Codex CLI ou o Gemini CLI (Willison, 2025). A OpenAI adotou o formato dentro de 48 horas após a abertura do padrão em dezembro de 2025, e o próprio agente de compras de empresas começou a avaliar o suporte a skills como critério de plataforma. Em meados de 2026, o showcase oficial lista mais de 40 clientes, incluindo todos os grandes agentes de código (agentskills.io, 2026). Quando o concorrente direto adota seu formato sem negociação, o formato virou infraestrutura.
Terceira: a indústria consolidou o formato como camada de empacotamento. O Agent Plugins 1.0.0, publicado em 6 de agosto de 2026, define um manifesto plugin.json com local fixo para skills e servidores MCP, suportado por ChatGPT, Codex, Cursor, GitHub Copilot, Kiro e VS Code (Hefner, 2026). A leitura estratégica é clara: skills deixaram de ser feature de um produto e viraram componente portável de ecossistema, empacotadas junto com o MCP na mesma caixa neutra. A pergunta de arquitetura "skills ou MCP?" também está respondida: MCP conecta o agente a ferramentas externas, skill ensina o procedimento de usá-las. São camadas complementares, e a skill pode referenciar o servidor MCP dentro das próprias instruções (Anthropic, 2025).
A tese: quando a capability vira commodity, o moat migra
Aqui está o ponto que interessa a quem constrói produto de IA. Durante uma década, o diferencial de um fornecedor estava no que o software fazia de único. Em agentes, esse diferencial tinha dois endereços: o modelo (que você não treina) e o prompt (que ninguém versiona). O padrão de skills desloca os dois.
O que o padrão comoditizou. Ensinar procedimentos a agentes, antes atividade artesanal de prompt engineering, agora é formato aberto, lido por 40+ ferramentas e empacotado por um consórcio dos maiores vendors do mundo. A capability "nosso agente sabe executar fluxo X" deixou de ser diferencial: qualquer agente lê o SKILL.md que ensina o fluxo X. A skill genérica, que replica o que qualquer tutorial ensina, vale o que vale um arquivo de Markdown: nada, sozinha.
Para onde o moat migrou. Três camadas ficam fora do padrão e são as que importam.
1. Conhecimento de domínio que não está em tutorial nenhum. A skill genérica "como fazer análise de dados" é commodity. A skill "como a Ouvidoria de um órgão público brasileiro tria um dossiê de manifestação, com as exceções do regulamento, os prazos do Decreto aplicável e os erros que o estagiário comete no primeiro mês" é ativo. Esse conhecimento mora na cabeça de quem opera o processo, não no Hugging Face. Quem o codifica em skills testadas tem uma biblioteca que nenhum vendor global consegue copiar, porque não é formato, é conteúdo.
2. Contexto institucional. Um agente que executa um procedimento sem conhecer a hierarquia, o vocabulário interno e os sistemas do cliente é um estagiário sem crachá. O padrão de skills não padroniza o contexto: ele exige que alguém o forneça. Para instituições, esse contexto é, em geral, sensível: organogramas, políticas, nomenclatura de sistemas legados. Quem opera dentro do perímetro do cliente, com dados residentes, carrega contexto que um SaaS global não pode carregar. É a mesma tese que sustenta a IA local: o moat não é o arquivo, é a proximidade com o dado.
3. Dados de uso. Skill que nunca foi executada é hipótese. Skill rodada mil vezes, com falhas catalogadas e descrições reescritas até o roteamento acertar, é aprendizado institucional acumulado. Aqui vale a conexão com o data flywheel que já discutimos neste blog: o ciclo de uso, erro e correção de uma biblioteca de skills é um dataset de como a organização realmente funciona (Ramalho, 2026). Ele não migra quando o cliente troca de agente, não é portável para o concorrente e compõe com os dados de operação da instituição. É a camada que mais se parece com software proprietário de verdade.
A síntese é uma frase: o formato virou commodity, o conhecimento não. Quem tratar skills como mais um hype de prompt vai produzir arquivos genéricos que qualquer concorrente replica em uma tarde. Quem tratá-las como ativo estratégico, com processo de autoria, avaliação e versionamento, vai acumular a única coisa que não vem no pacote do padrão.
O Brasil: skills em português são a camada que falta no pacote global
O ecossistema de skills nasceu em inglês, para workflows de engenharia de software e produtividade individual. O mercado brasileiro tem dois números que situam a oportunidade. A pesquisa TIC Empresas 2025, do Cetic.br, mostra que o uso de IA pelas empresas passou de 13% para 17%, chegando a 50% nas empresas de grande porte, e que 80% das empresas adotantes compram software pronto, enquanto 60% contratam fornecedores externos para desenvolver ou adaptar (Cetic.br, 2026). A pesquisa ABES/IDC aponta 53% dos executivos brasileiros colocando agentes de IA como prioridade de TI para 2026 (ABES/IDC, 2026).
A lacuna entre esses números e o estado da arte é o espaço. As skills públicas dominantes cobrem criar slide, revisar PR e formatar planilha. Nenhuma cobre instrução processual em um órgão de gestão pública brasileiro, triagem de manifesto em ouvidoria pelo regulamento local, ou o fluxo de uma prorrogação de contrato na linguagem do edital. Há um repertório inteiro de procedimentos institucionais brasileiros, em português, regulados por normativos locais, que nenhum template global cobre. Para instituições brasileiras, skills em PT-BR alinhadas aos normativos nacionais não são localização: são a diferença entre um agente genérico e um agente que o time confia para operar o processo real.
E há o vetor soberania. Uma skill institucional carrega, no corpo do texto, o conhecimento do processo: quem aprova, em qual sistema, com qual prazo. Em banco, em órgão público, em operadora de saúde, isso é informação sensível. O padrão de skills não define onde a pasta mora, quem a lê e para onde vai o log de execução. Isso é definido pela arquitetura de cada deploy. Rodar a biblioteca de skills dentro do perímetro do cliente, com modelo local, é o mesmo argumento da IA soberana aplicado à camada que ninguém estava olhando: a do conhecimento processual (Camilo, 2026).
O playbook: transformar processo em biblioteca de skills
Para uma instituição começando, cinco movimentos compõem a operação mínima viável.
1. Mapear por evidência, não por imaginação. A Anthropic recomenda começar com avaliação: rode o agente nas tarefas representativas, observe onde ele falha ou pede contexto, e construa skills incrementalmente para cobrir exatamente essas lacunas (Anthropic, 2025). A skill nasce do erro real, não do workshop teórico de mapeamento de processos.
2. Uma skill, um procedimento, uma descrição precisa. Corpo enxuto, detalhe empurrado para o nível 3, descrição que diz quando usar e quando não usar. Descrição vaga é o bug número um do roteamento, e descrições colidentes produzem seleção não determinística entre skills.
3. Versionar como código. A pasta é texto. Git, code review, semver, rollback. Aqui a skill encontra a governança que já discutimos neste blog: o prompt deixa de ser artefato efêmero de conversa e vira ativo auditável, com histórico de quem mudou o quê, quando e por quê (Barbedo, 2026). Para setores regulados, essa é a ponte entre a agilidade do agente e a exigência de rastreabilidade do compliance.
4. Codificar o código determinístico como código. Se um passo do procedimento é determinístico, não descreva em prosa para o modelo imitar: empacote como script e mande o agente executar. O script roda igual toda vez, não entra na janela de contexto e é auditável linha a linha. A regra prática: o modelo decide, o código executa.
5. Fechar o loop com dados de uso. Log de execução por skill, taxa de acionamento, taxa de sucesso nas tarefas que a skill deveria melhorar. A biblioteca vira flywheel quando a revisão mensal olha os dados e reescreve as skills que falham, não quando olha o que o time acha que deveria existir.
O que fica
O padrão de skills venceu porque era a coisa certa mais simples possível: um arquivo Markdown que qualquer agente lê. Com mais de 40 ferramentas lendo o mesmo formato e um consórcio de vendors empacotando-o como infraestrutura, ensinar procedimentos a agentes deixou de ser diferencial de produto. O moat migrou para as camadas que o padrão não padroniza: o conhecimento de domínio que só quem opera o processo tem, o contexto institucional que só quem está dentro do perímetro carrega e os dados de uso que só quem roda em produção acumula.
Na BaXiJen, essa é a leitura que guia o que construímos: um agente é tão bom quanto a biblioteca de procedimentos que ele carrega, e essa biblioteca, para instituições brasileiras, precisa nascer em português, alinhada aos normativos locais e residente no perímetro do cliente. O formato é aberto. O conhecimento, esse é nosso e de quem opera o processo com a gente.
Referências
ABES/IDC. (2026). Agentes de IA e IA generativa como prioridade de TI para 2026: 53% dos executivos brasileiros. Citado em Luby. Recuperado de https://luby.com.br/blog/agentes-de-ia-53-das-empresas-brasileiras-priorizam-em-2026
agentskills.io. (2026). Client Showcase: agent products that support the Agent Skills format. Recuperado de https://agentskills.io/clients
Anthropic. (2025, 16 outubro). Equipping agents for the real world with Agent Skills. Anthropic Engineering. Recuperado de https://www.anthropic.com/engineering/equipping-agents-for-the-real-world-with-agent-skills
Anthropic. (2025, 16 outubro). Introducing Agent Skills. Recuperado de https://claude.com/blog/skills
Barbedo, L. F. (2026). Governança de agentes IA: do guardrail ao compliance auditável. BaXiJen. Recuperado de https://www.baxijen.com.br/blog/governanca-agentes-ia-do-guardrail-ao-compliance-auditavel
Camilo, L. (2026). IA Soberana para o Brasil. BaXiJen. Recuperado de https://www.baxijen.com.br/blog/ia-soberana-para-o-brasil
Cetic.br/NIC.br. (2026, 15 junho). Uso de Inteligência Artificial por empresas brasileiras avança e atinge 17%. 16ª edição da pesquisa TIC Empresas. Recuperado de https://cetic.br/pt/noticia/uso-de-inteligencia-artificial-por-empresas-brasileiras-avanca-e-atinge-17-aponta-pesquisa-do-cetic-br
Hefner, J. (2026, 6 agosto). Introducing Agent Plugins 1.0.0. Vercel. Recuperado de https://vercel.com/blog/introducing-agent-plugins
Ramalho, M. (2026). Data flywheel: como agentes que aprendem com uso superam modelos estáticos. BaXiJen. Recuperado de https://www.baxijen.com.br/blog/data-flywheel-agentes-que-aprendem-com-uso-superam-modelos-estaticos
Willison, S. (2025, 16 outubro). Claude Skills are awesome, maybe a bigger deal than MCP. Recuperado de https://simonwillison.net/2025/Oct/16/claude-skills/
Por Leonardo Camilo, Co-fundador e CEO na BaXiJen. Doutorando em Sistemas de Decisão e IA na COPPEAD/UFRJ, pesquisador no CID/UFF. Escreve sobre IA local, agentes em produção e soberania de dados.
Quer construir IA soberana?
Fale com a BaXiJen e descubra como agentes autônomos podem transformar sua operação.
Fale conoscoNewsletter semanal
Os posts da semana, direto no seu email
Receba em um único resumo os novos artigos sobre IA soberana, agentes autônomos e produto. Se não houver publicação nova, não enviamos nada.