IA em Ambientes Air-Gapped: Rodando LLMs Onde a Internet Não Chega
O Pentágono está concluindo a migração de 100% dos workloads de IA classificados para ambientes que controla fisicamente, com 90% já migrados. A Força Aérea americana rodou LLMs open-source self-hosted para 700 mil usuários dentro da própria rede e encerrou o sistema em 31 de dezembro de 2025. A Marinha do Brasil já opera framework de LLM sobre o repositório documental das fragatas Classe Tamandaré. Este guia decompõe o que muda tecnicamente quando um LLM precisa rodar sem internet: distribuição de pesos em duas fases, pipeline de atualização com mídia física, guardrails e observabilidade locais, e o playbook de implantação para instituições brasileiras que não podem expor dados sensíveis.
IA em Ambientes Air-Gapped: Rodando LLMs Onde a Internet Não Chega
Em 11 de setembro de 2026, o subsecretário de Defesa para Pesquisa e Engenharia dos Estados Unidos, Emil Michael, informou que cerca de 90% dos workloads de IA classificados do Pentágono já foram migrados para ambientes alternativos, com conclusão prevista para o fim de outubro. O motivo da migração foi uma disputa contratual, mas o detalhe que interessa a quem constrói infraestrutura é outro: a arquitetura de destino é um ecossistema multi-modelo rodando dentro de perímetros que o Departamento de Defesa controla fisicamente, não uma API aberta na internet (DefenseScoop, 2026a).
Essa é a versão de alto orçamento de um movimento que já alcança hospitais, tribunais, agências fiscais e indústrias reguladas no mundo inteiro: rodar IA generativa onde a internet, simplesmente, não chega. O cenário tem nome técnico, air-gapped, e deixou de ser nicho de defesa para virar requisito de compra em qualquer instituição que manipule dados sigilosos. A Força Aérea dos EUA operou um chatbot com LLMs open-source self-hosted para mais de 700 mil usuários dentro da própria rede não classificada (CIO, 2024; DefenseScoop, 2025a). A Marinha do Brasil já publica framework de gestão de conhecimento baseado em LLM aplicado ao repositório documental das fragatas Classe Tamandaré, alinhado ao seu plano estratégico de 2040 (Silva; Luna, 2025).
Este artigo decompõe o que muda na prática quando não existe rota de saída para a internet: como os pesos do modelo chegam ao ambiente isolado, como o pipeline de atualização funciona sem um pip install em runtime, quais camadas da stack quebram e como repará-las. É o guia que eu gostaria de ter lido antes do primeiro deploy offline da BaXiJen.
O que é air gap de verdade
Air gap significa isolamento físico: nenhuma rota lógica ou física liga o ambiente à internet ou a redes não confiáveis. O servidor de inferência não tem gateway para fora. O cluster Kubernetes não acessa registros de imagens remotos. Não existe chave de API em nenhum arquivo de configuração, porque não há para onde enviá-la.
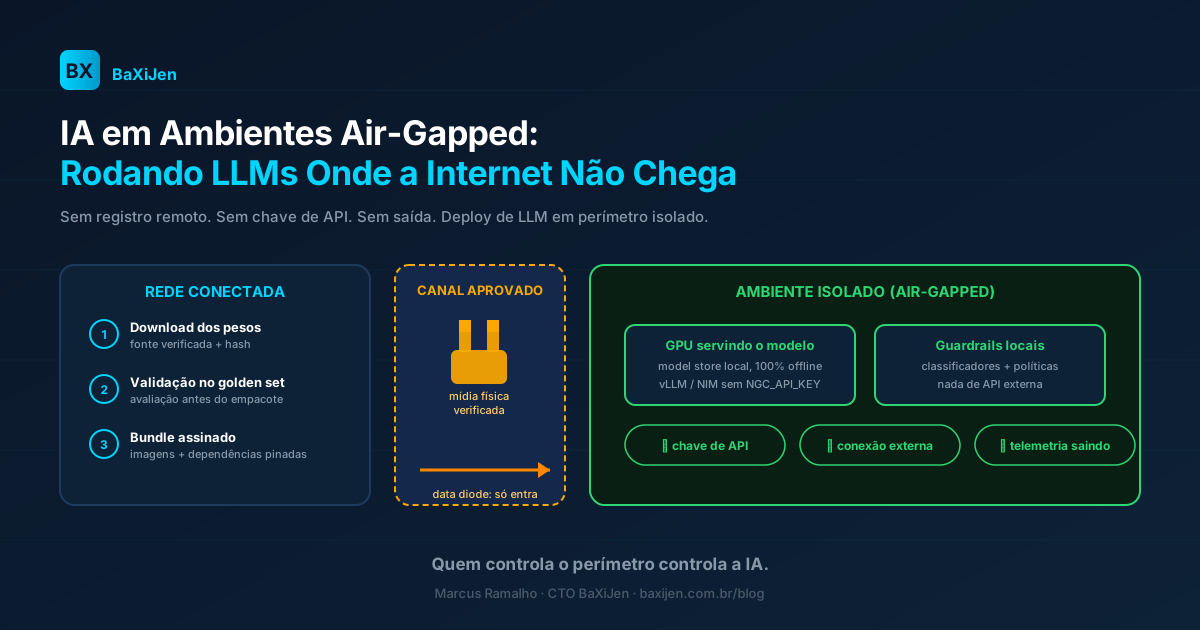
A documentação da NVIDIA para deploy de NIM em air gap é explícita sobre o padrão: o ambiente isolado roda sem conexão com registros de modelos como NGC ou Hugging Face Hub, sem chaves NGC_API_KEY ou HF_TOKEN, carregando todos os artefatos exclusivamente de armazenamento local (NVIDIA, 2026a). A diferença para um deploy on-premise comum é exatamente essa: on-premise com saída controlada ainda pode pullar imagens, chamar guardrails externos e exportar telemetria. Air-gapped não pode nada disso. O que entra, entra por um canal aprovado: mídia física verificada, transferência unidirecional via data diode ou repositório intermediário em bastion host (NVIDIA, 2026b).
Uma tese do MIT publicada em 2025 resume o argumento estratégico do padrão: quando o modelo é hospedado, ajustado e consultado inteiramente dentro do ambiente seguro, todas as entradas, computações e saídas permanecem sob controle de quem opera o perímetro (MIT, 2025). Não é paranoia. É o mesmo princípio que fez hospitais manterem prontuários em servidores locais por vinte anos, agora aplicado a um componente que conversa.
O laboratório americano: o que 700 mil usuários ensinaram
O caso mais documentado de IA generativa em rede militar fechada é o NIPRGPT. Lançado em 2024 pelo Air Force Research Laboratory (AFRL) como parte do ecossistema Dark Saber, o chatbot operava na NIPRNet, a rede não classificada do Pentágono. A escolha técnica do AFRL é o dado mais interessante para engenheiros: o laboratório experimentava LLMs open-source self-hosted em ambiente controlado, sem treinar o modelo e sem refinar respostas a partir das entradas dos usuários (CIO, 2024). Modelo próprio, pesos próprios, rede própria.
O uso explodiu: mais de 700 mil pessoas usaram a plataforma em todo o Departamento de Defesa durante a fase de piloto (DefenseScoop, 2025a). E o encerramento ensinou a segunda lição, ainda mais valiosa: quando o GenAI.mil, a plataforma enterprise do Pentágono, entrou em operação em dezembro de 2025, o NIPRGPT foi desativado em 31 de dezembro, com apenas três semanas de janela de transição, e o Departamento da Força Aérea não disponibilizou ferramenta de exportação para os dados e workflows acumulados pelos usuários (DefenseScoop, 2025a). Quem tinha conteúdo crítico na plataforma precisou reconstruí-lo por conta própria.
Guarde essa lição para o fim do artigo, porque ela inverte a leitura óbvia. O problema não foi o modelo. Foi a ausência de um objeto de transição: ferramenta de exportação, formato aberto, plano de migração. Em IA sensível, a portabilidade dos artefatos, prompts, bases de conhecimento e histórico, importa tanto quanto a segurança do perímetro.
Enquanto isso, na rede secreta, a DISA desenvolvia o SIPRGPT, chatbot experimental para a SIPRNet voltado ao Indo-Pacific Command, em processo de credenciamento anunciado em março de 2025 (DefenseScoop, 2025b). E em janeiro de 2025, o GPT-4o foi autorizado para uso em nível Top Secret no Azure for U.S. Government Top Secret (DefenseScoop, 2025c), com autorização posterior para todos os níveis de classificação (Microsoft, 2026). Ou seja: as três arquiteturas conviveram, nuvem classificada de hiperescala, plataforma enterprise em rede própria e self-hosting de open-source, porque resolvem problemas diferentes.
A tabela resume o panorama:
| Plataforma | Ambiente | O que roda | Status |
|---|---|---|---|
| NIPRGPT | NIPRNet (rede não classificada) | LLMs open-source self-hosted, sem treino, sem feedback de entradas | Encerrado em 31/12/2025 |
| SIPRGPT | SIPRNet (rede secreta) | Chatbot experimental da DISA para indo-pacífico | Em credenciamento (2025) |
| GenAI.mil | Plataforma enterprise do DoD | Gemini, ChatGPT Mil (GPT-5.4 Terra) e Grok, todos IL5 | Em produção, 3+ milhões de usuários previstos |
| Azure Gov Top Secret | Nuvem classificada | GPT-4o autorizado para Top Secret | Autorizado desde jan/2025 |
Fontes: DefenseScoop (2025a, 2025b, 2025c, 2026b), Microsoft (2026).
O episódio Anthropic fecha o quadro. O Departamento de Defesa designou a empresa como risco de cadeia de suprimento em meados de 2026, exigindo a remoção dos modelos de todos os sistemas de segurança nacional. Um juiz federal chegou a considerar a designação ilegal, mas a migração seguiu: 90% dos workloads classificados migrados até setembro, resto até outubro (DefenseScoop, 2026a; DefenseScoop, 2026b). Para quem projeta infraestrutura, o episódio valida a arquitetura multi-modelo: o Pentágono trocou de fornecedor de modelo frontier sem parar as operações porque a camada de integração, dados e workflow era dele, não do vendedor.
O que muda tecnicamente: sem internet, nada de pull
Aqui entra a parte que eu gosto. Um deploy de LLM tem seis pontos de contato implícitos com a internet. Em air gap, cada um precisa de projeto.
1. Distribuição dos pesos
É o primeiro problema e o mais pesado, literalmente. Um modelo de 70 bilhões de parâmetros em FP16 ocupa cerca de 140GB. Em INT4, algo em torno de 35GB. Seja qual for o tamanho, o peso precisa atravessar a fronteira do perímetro.
O fluxo da NVIDIA para NIM é o padrão de referência, em duas fases (NVIDIA, 2026a):
| Fase | Onde | O que acontece |
|---|---|---|
| Conectada | Máquina com internet e credenciais | Download dos assets do modelo, download-to-cache, criação de model store opcional |
| Air-gapped | Máquina isolada | Montagem dos assets pré-estagiados, execução do container sem rede e sem chaves de API |
| Transferência | Canal aprovado entre as fases | Archive físico, scp, rsync ou mídia removível |
O detalhe que quebra deploy ingênuo está na fase 2: variáveis de ambiente como NGC_API_KEY e HF_TOKEN não devem existir no ambiente isolado. Se existirem, o runtime tenta autenticar em algum lugar, e a tentativa falha ruidosamente ou, pior, silenciosamente. A regra prática: se o processo de inferência consegue sequer tentar uma conexão de saída, o deploy ainda não está pronto.
2. Dependências de código
Nenhum pip install em runtime. Nenhum npm install. O container de inferência precisa entrar no perímetro com tudo dentro: runtime, kernels CUDA, tokenizer, dependências pinadas. Em clusters OpenShift desconectados, o GPU Operator da NVIDIA documenta o caminho completo: mirror registry em bastion host com conectividade às duas redes ou, no caso de air gap total, mídia removível carregando o catálogo espelhado, porque o Operator Lifecycle Manager não alcança o OperatorHub remoto por definição (NVIDIA, 2026b). O mesmo vale para cada componente da stack: vLLM, SGLang, monitoramento, frontend. Tudo entra como imagem espelhada ou bundle assinado.
3. Pipeline de atualização
Sem internet, atualizar modelo deixa de ser um docker pull e vira um processo logístico. O padrão que funciona é tratar cada update como release formal: no ambiente conectado, valida-se a nova versão do modelo contra o golden set de avaliação, empacota-se tudo com hashes verificáveis, transfere-se pelo canal aprovado e valida-se a integridade do outro lado antes de promover a produção. A cadência vira trimestral ou mensal, não contínua. Parece perda, e é. Mas é também o fim da ilusão de que atualizar modelo em produção é seguro porque "é só trocar a tag". Na prática, a janela forçada de avaliação offline captura regressões que o deploy contínuo deixa passar.
4. As camadas que quebram
A tabela abaixo mapeia o que quebra em cada camada e a mitigação que usamos:
| Camada | O que quebra sem internet | Mitigação |
|---|---|---|
| Registro de modelos | Download de pesos no startup | Model store pré-estágio, carregamento 100% local |
| Dependências | pip/npm em runtime | Bundle completo ou mirror interno no bastion |
| Updates | Pull automático de nova versão | Janela de transferência com verificação de hash |
| Guardrails | Chamadas a APIs externas de moderação | Guardrails locais: classificadores, filtros e políticas no perímetro |
| Observabilidade | Exportadores para SaaS de monitoramento | Stack local completa, métricas e traces nunca saem |
| Avaliação | Benchmarks e datasets online | Golden set versionado internamente, avaliação por regressão a cada release |
O ponto sobre guardrails merece destaque porque é onde mais vejo projeto bom morrer na integração. Muito pipeline de 2026 depende de chamada externa para classificação de conteúdo ou checagem de política. Em ambiente isolado, o guardrail precisa rodar dentro: modelos de classificação menores, listas de políticas versionadas e regras de decisão auditáveis no mesmo perímetro onde roda o LLM.
5. Hardware
Não existe autoscaling de nuvem. A GPU que existe no dia do deploy é a GPU que existe no pico. Isso muda o dimensionamento: superdimensionar é o padrão, e técnicas de eficiência deixam de ser otimização e viram habilitador. Quantização INT4, speculative decoding e KV cache otimizado permitem servir mais usuários no mesmo silício. Um servidor com duas GPUs de 24GB roda um modelo 8B quantizado com folga para centenas de usuários internos concurrentes, o que cobre a maioria dos órgãos públicos brasileiros.
O Brasil: o perímetro já é requisito
O movimento americano tem paralelo direto no Brasil, e não é projeção: já está em norma e em produção documentada.
Em 24 de agosto de 2026, o Ministério da Defesa instituiu a Política de Inteligência Artificial de Defesa pela Portaria GM-MD nº 4.360. O texto determina que o país desenvolva capacidades autóctones para projetar, fabricar, controlar e proteger a própria infraestrutura digital e os sistemas críticos de IA, com o objetivo declarado de reduzir dependência de fornecedores externos e vulnerabilidades tecnológicas estratégicas (Forças Terrestres, 2026). É a versão nacional da mesma conclusão do Pentágono: em sistema crítico, quem não controla a stack não controla a missão.
A Marinha foi além da norma e publicou a implementação. O framework apresentado na Revista Pesquisa Naval aplica LLM ao repositório documental das fragatas Classe Tamandaré, transformando arquivo estático em base de conhecimento interativa com um Modo Consulta para recuperação precisa e um Modo Assistente para capturar conhecimento tácito, como lições aprendidas, antes que a rotação de pessoal o dissolva. O trabalho cita um dado interno que explica a motivação: entre 2014 e 2017, a movimentação anual afetou em média 16,9% do efetivo, dificultando a manutenção de especialização. O projeto é explicitamente alinhado ao Plano Estratégico da Marinha 2040 como passo de soberania tecnológica (Silva; Luna, 2025).
O Exército, por sua vez, mantém dezenas de projetos de pesquisa financiados pela FINEP, incluindo IA, defesa cibernética e tecnologias autônomas (Defesa em Foco, 2026). E no regulatório, o Marco Legal da IA segue em tramitação: o PL 2.338/2023, aprovado no Senado em dezembro de 2024, aguarda votação na Câmara em 2026 (Barbieri Advogados, 2026). Enquanto a lei geral não vem, a LGPD, Lei nº 13.709/2018, segue como base vigente de conformidade, e ela basta para o argumento: dado pessoal sigiloso em API estrangeira é risco jurídico, técnico e reputacional simultâneo.
Onde isso conecta com o resto do setor público: o mesmo padrão que protege um documento militar protege um prontuário hospitalar, um processo judicial em segredo de justiça, uma declaração fiscal de contribuinte. O air gap é o extremo do espectro on-premise que a BaXiJen atende, e a fronteira entre "on-premise com saída controlada" e "air-gapped" é mais fina do que parece: ela se atravessa com uma política de rede, não com uma reimplementação.
Playbook de implantação air-gapped
Compilando o que as fontes e a prática mostram, o deploy offline de LLM tem três fases e uma regra de ouro.
Fase 1: preparo no ambiente conectado. Baixe os pesos de fonte confiável, verifique os hashes, valide o modelo contra um golden set de avaliação e empacote tudo o que a fase 2 precisa: imagens de container espelhadas, dependências pinadas, configuracões sem nenhuma credencial de API. Documente o conteúdo do bundle: é o mesmo princípio de manifest de release que você usaria para software convencional.
Fase 2: transferência pelo canal aprovado. Mídia física verificada, data diode ou bastion host, conforme a política do perímetro. Do outro lado, valide a integridade de novo antes de montar. O canal de transferência é o novo ataque surface: trate cada bundle como artefato de entrada de confiança parcial até passar por verificação.
Fase 3: operação no ambiente isolado. Monte o model store local, suba o runtime sem variáveis de credencial, ative o guardrail local e a stack de observabilidade local, e estabeleça o ciclo de atualização com janela definida. Cada update repete as fases 1 e 2: avaliar, empacotar, transferir, verificar, promover.
A regra de ouro: espelhe antes de isolar. O ambiente de staging conectado deve ser réplica 1:1 do ambiente isolado, mesmas versões, mesmas configurações, mesmo golden set. Tudo que você valida no espelho é o que vai funcionar no perímetro. Tudo que você "vai ajustar lá dentro" é dívida técnica com juros de manutenção programada e gente esperando.
E a lição do NIPRGPT, que guardei do meio do artigo: projete a saída antes da entrada. Formato aberto para os artefatos, exportação testada de prompts e bases de conhecimento, plano de migração documentado. O perímetro protege os dados contra o exterior, mas só a portabilidade protege o usuário contra o próprio sistema.
O que fica
IA air-gapped deixou de ser excentricidade de defesa para virar segmento com playbook público: os americanos documentaram os fracassos (três semanas de transição sem ferramenta de exportação) e as vitórias (700 mil usuários em rede fechada com modelo próprio), a NVIDIA industrializou a distribuição de pesos em duas fases, e o Brasil colocou a exigência de capacidades autóctones em portaria ministerial enquanto a Marinha roda LLM em repositório documental de fragata. Quem controla o perímetro controla a IA. E quem projeta a portabilidade controla o futuro do próprio deploy.
É o mesmo princípio que a BaXiJen aplica em cada cliente: soberania de dados não é discurso, é arquitetura. E arquitetura, aqui, se projeta para funcionar até onde a internet não chega.
Por Marcus Ramalho, CTO e cofundador na BaXiJen.
Referências
- Barbieri Advogados. (2026). Regulamentação da Inteligência Artificial no Brasil 2026. https://www.barbieriadvogados.com/regulamentacao-inteligencia-artificial-brasil/
- CIO. (2024). US Air Force seeks generative AI test pilots. https://www.cio.com/article/2145797/us-air-force-seeks-generative-ai-test-pilots.html
- Defesa em Foco. (2026). Forças Armadas aceleram projetos de inteligência artificial para a Defesa. https://www.defesaemfoco.com.br/forcas-armadas-aceleram-projetos-de-inteligencia-artificial-para-a-defesa/
- DefenseScoop. (2025a). Air Force sunsetting NIPRGPT generative AI platform by Dec. 31. https://defensescoop.com/2025/12/18/air-force-sunsetting-niprgpt-generative-ai-platform/
- DefenseScoop. (2025b). DISA launching experimental cloud-based chatbot for Indo-Pacific Command. https://defensescoop.com/2025/03/25/disa-siprgpt-chatbot-indopacom-joint-operational-edge-cloud/
- DefenseScoop. (2025c). OpenAI's GPT-4o gets green light for top secret use in Microsoft's Azure cloud. https://defensescoop.com/2025/01/16/openais-gpt-4o-gets-green-light-for-top-secret-use-in-microsofts-azure-cloud/
- DefenseScoop. (2026a). DOD poised to move all classified AI workloads off Anthropic by October. https://defensescoop.com/2026-09-11/dod-poised-to-move-all-classified-ai-workloads-off-anthropic-by-october/
- DefenseScoop. (2026b). Grok and ChatGPT join Gemini in Pentagon's enterprise genAI portal. https://defensescoop.com/2026/08/31/grok-chatgpt-added-to-genai-mil/
- Forças Terrestres. (2026). Ministério da Defesa aprova política de Inteligência Artificial para acelerar decisões militares e reduzir dependência tecnológica. https://www.forte.jor.br/2026/08/30/ministerio-da-defesa-aprova-politica-de-inteligencia-artificial-para-acelerar-decisoes-militares-e-reduzir-dependencia-tecnologica/
- MIT. (2025). Securing Intelligence: The Strategic Necessity of Air-Gapped AI Systems. MIT Lincoln Laboratory. https://dspace.mit.edu/bitstream/handle/1721.1/164901/
- Microsoft. (2026). Azure OpenAI Service now authorized for all U.S. Government data classification levels. Microsoft Azure Government DevBlog. https://devblogs.microsoft.com/azuregov/azure-openai-authorization/
- NVIDIA. (2026a). Air-Gap Deployment: NVIDIA NIM for Large Language Models. https://docs.nvidia.com/nim/large-language-models/latest/deployment/air-gap-deployment.html
- NVIDIA. (2026b). Deploy GPU Operators in a disconnected or airgapped environment: NVIDIA GPU Operator on Red Hat OpenShift. https://docs.nvidia.com/datacenter/cloud-native/openshift/24.9.0/mirror-gpu-ocp-disconnected.html
- Silva, R. B. C.; Luna, G. S. (2025). Soberania pelo Conhecimento: um framework de inteligência artificial para a gestão do conhecimento estratégico na Marinha do Brasil. Revista Pesquisa Naval, nº 37. https://portaldeperiodicos.marinha.mil.br/index.php/pesquisanaval
Quer construir IA soberana?
Fale com a BaXiJen e descubra como agentes autônomos podem transformar sua operação.
Fale conoscoNewsletter semanal
Os posts da semana, direto no seu email
Receba em um único resumo os novos artigos sobre IA soberana, agentes autônomos e produto. Se não houver publicação nova, não enviamos nada.